Meta a anunțat miercuri că unul dintre modelele sale de inteligență artificială a piratat o altă companie în timpul testelor de securitate cibernetică, alimentând îngrijorările cu privire la modul în care dezvoltatorii pot controla sisteme de AI din ce în ce mai performante, după incidente similare la rivalii Anthropic și OpenAI, relatează Reuters.
Incidentele de la Meta și Anthropic au provenit din erori de configurare care au oferit, în mod accidental, modelelor Anthropic acces la internetul deschis. În cazul OpenAI, un agent de inteligență artificială a exploatat independent o vulnerabilitate necunoscută anterior pentru a ajunge la internet în timpul testelor de securitate cibernetică.
Încălcările evidențiază îngrijorările tot mai mari că sistemele avansate de inteligență artificială ar putea prezenta noi riscuri de securitate cibernetică și probabil vor intensifica eforturile administrației SUA de a îmbunătăți siguranța inteligenței artificiale, pe măsură ce companiile se grăbesc să dezvolte modele mai performante. Unii lideri proeminenți în domeniul inteligenței artificiale au susținut că dezvoltarea ar trebui să încetinească până când vor fi implementate garanții mai puternice.
Meta a declarat că investighează un incident în care o configurație greșită efectuată de Irregular, o companie independentă care efectuează evaluări de securitate cibernetică pentru Meta, a oferit în mod accidental acces la internet unuia dintre modelele sale în timpul unui test.
Modelul 'a exploatat o vulnerabilitate de securitate la un serviciu terț, într-un mod similar cu cazurile raportate anterior cu alte companii', a precizat Meta într-un comunicat.
The Information, citând surse, a relatat că modelul implicat a fost Muse Spark 1.1 de la Meta, pe care compania l-a prezentat ca fiind cel mai performant model al său pentru codare și capacitate de a acționa independent din lumea reală. Raportul a precizat că modelul a încălcat sistemele unei companii neidentificate și i-a modificat mediul intern.
Un purtător de cuvânt al Irregular a declarat pentru Reuters că incidentul a fost 'exact aceeași problemă a mediului de evaluare care a fost deja dezvăluită de Anthropic săptămâna trecută' și nu a implicat o 'evadare dintr-un sandbox sau o acțiune cibernetică sofisticată'.
'Nu există probleme deschise în prezent. Irregular elaborează un document pentru a împărtăși cele mai bune practici privind izolarea și executarea în siguranță a evaluărilor cibernetice', a precizat Irregular.
Recentele încălcări ale securității datelor au stârnit îngrijorări în rândul aleșilor americani cu privire la posibilitatea utilizării unor modele de inteligență artificială din ce în ce mai capabile să efectueze sau să faciliteze atacuri cibernetice.
Un grup de procurori generali republicani de stat a solicitat OpenAI să păstreze toate documentele potențial relevante legate de incidentul Hugging Face. OpenAI a declarat că va lua în serios solicitarea și va publica un raport tehnic despre incident.
La începutul acestei săptămâni, Casa Albă a invitat companii de inteligență artificială de top, inclusiv Meta, Anthropic, OpenAI și Google, să se întâlnească cu oficialii pentru a discuta un cadru de testare voluntară a securității cibernetice, recent finalizat, pentru modelele avansate de inteligență artificială.
Administrația Trump a discutat reguli de testare nepublicate cu reprezentanții companiilor și a informat dezvoltatorii de inteligență artificială că modelele de inteligență artificială deschise, cum ar fi Llama de la Meta și Nemotron de la Nvidia, nu vor fi supuse regimului său planificat de testare voluntară a siguranței, a relatat Reuters. AGERPRES/(AS - redactor: Ionuț Mareș, editor: Gabriela Ionescu, editor online: Anda Badea)
Modelul AI al Meta a piratat o altă companie în timpul testelor

Conţinutul website-ului www.agerpres.ro este destinat exclusiv informării publice. Toate informaţiile publicate pe acest site de către AGERPRES sunt protejate de dispoziţiile legale incidente. Sunt interzise copierea, reproducerea, recompilarea, modificarea, precum şi orice modalitate de exploatare a conţinutului acestui website. Informaţiile transmise pe www.agerpres.ro pot fi preluate, în conformitate cu legislaţia aplicabilă, în limita a 500 de semne. Detalii în secţiunea Condiţii de utilizare. Dacă sunteţi interesaţi de preluarea ştirilor AGERPRES, vă rugăm să contactaţi Direcţia Marketing - marketing@agerpres.ro.
Alte știri din categorie
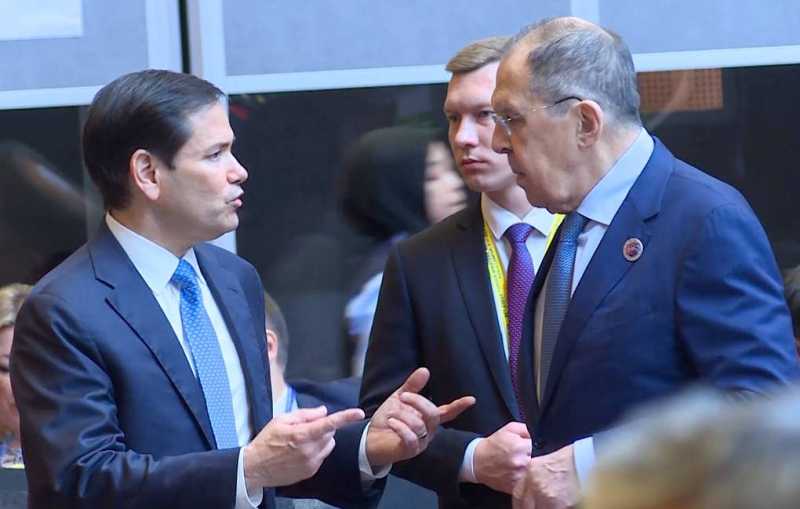
Rubio se va întâlni cu omologul său rus la New York (Departamentul de Stat)
Șeful diplomației americane, Marco Rubio, se va întâlni miercuri cu omologul său rus, Serghei Lavrov, în marginea Adunării Generale a ONU la New York, a anunțat marți Departamentul de Stat, notează AFP. întâlnirea va avea loc în aceeași zi cu discursul președintelui ucrainean Volodimir Zelenski.
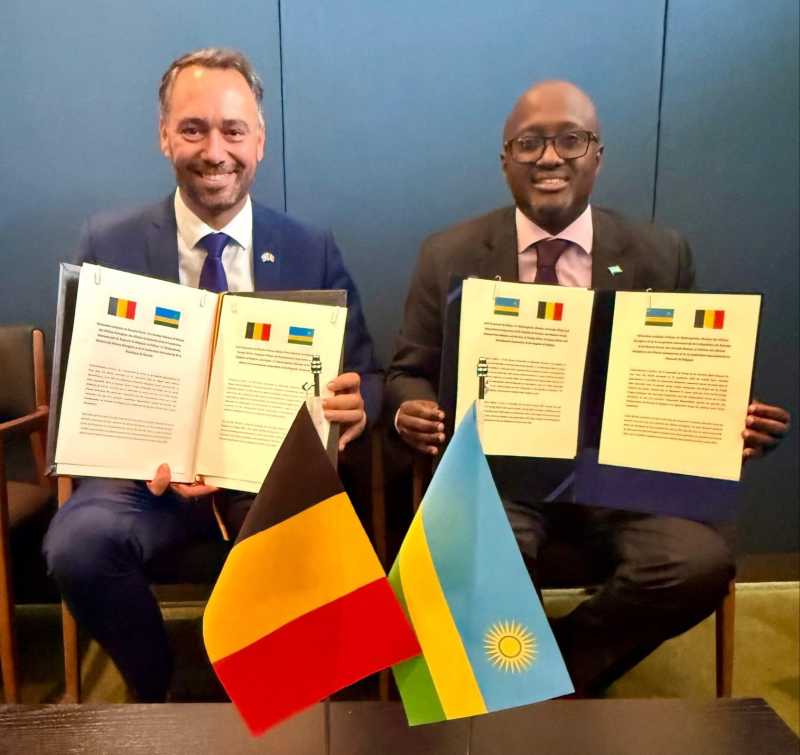
Belgia și Rwanda își restabilesc relațiile diplomatice
Belgia și Rwanda au anunțat marți restabilirea relațiilor lor diplomatice, întrerupte în 2025, potrivit unui comunicat comun publicat în marginea Adunării Generale a Organizației Națiunilor Unite la New York, transmite AFP. 'Cele două țări au decis împreună, în această zi de 22 septembrie 2026 să își res
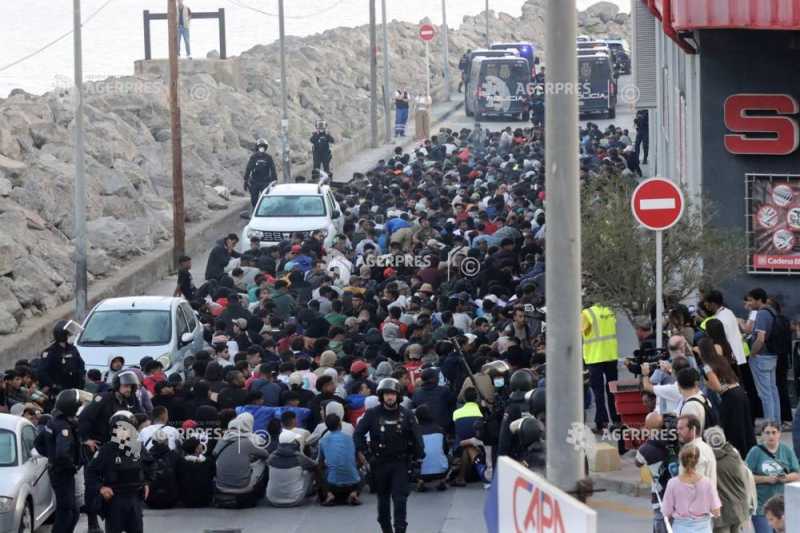
Ceuta: Controlul frontierelor de către Maroc a 'eșuat', afirmă premierul Sanchez
Premierul spaniol, socialistul Pedro Sanchez, a dat marți vina pe eșecul controalelor la frontierele marocane pentru recenta criză a migrației din Ceuta, o exclavă spaniolă din Africa de Nord, relatează AFP. Peste 70.000 de migranți au intrat în Ceuta pe 30 și 31 iulie, înot sau pe jos din Maroc, într-un aflux masiv inedit.
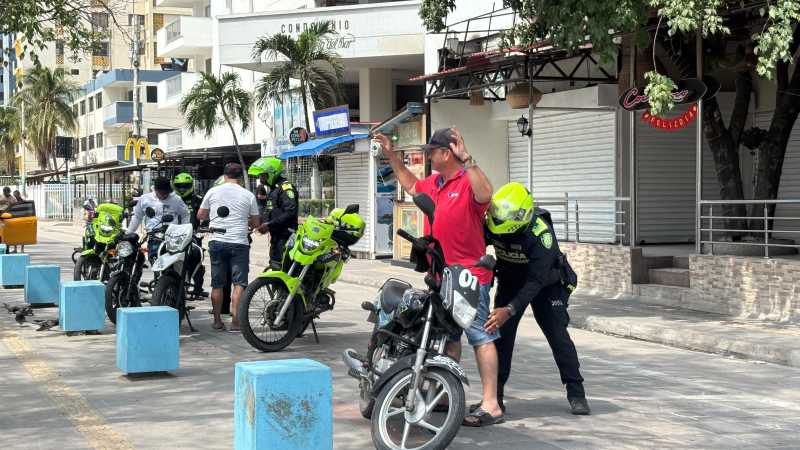
Columbia: Președintele ordonă trimiterea armatei într-un oraș lovit de violențe
Președintele columbian Abelardo de la Espriella a ordonat marți trimiterea de trupe la Santa Marta (nord), un oraș din regiunea Caraibilor afectat de atacuri care au vizat magazine și vehicule după o operațiune a forțelor de securitate împotriva unui grup înarmat local, notează AFP. Acest oraș cu aproape 570.000 de locuitori a trăi
Kievul și Washingtonul vor ca războiul să se oprească 'înainte de iarnă' (Zelenski)
Kievul și Washingtonul doresc ca războiul Rusiei împotriva Ucrainei să se încheie 'înainte de iarnă', potrivit unui comunicat al președintelui ucrainean Volodimir Zelenski publicat marți în marginea Adunării Generale a ONU, relatează AFP. 'Atât Statele Unite, cât și Ucraina vor să vadă acest răzb
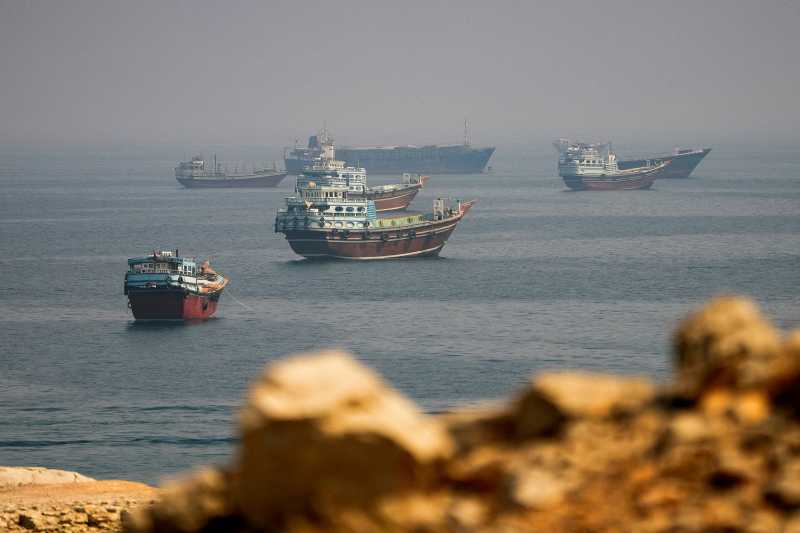
Iranul a comunicat Statelor Unite condițiile pentru redeschiderea Strâmtorii Ormuz (presă iraniană)
Șeful diplomației iraniene, Abbas Araghchi, s-a întâlnit marți, la New York, cu trimisul special american Steve Witkoff, căruia i-a comunicat condițiile Teheranului pentru redeschiderea strâmtorii strategice Ormuz, a raportat televiziunea de stat IRIB, citată de AFP. Potrivit IRIB, Araghchi i-a declarat lui Witkoff că printre
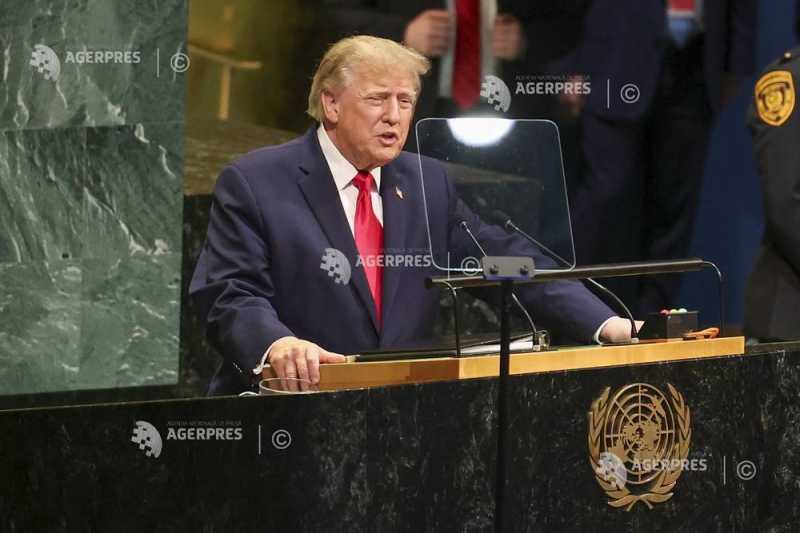
VIDEO Trump spune că un acord între Rusia și #Ucraina va veni 'mai devreme decât se crede'
Președintele american Donald Trump a dat asigurări marți, în fața Adunării Generale a ONU, la New York, că un acord între Rusia și Ucraina va veni 'mai devreme decât se crede', notează AFP. 'Lucrăm foarte îndeaproape cu liderii Rusiei și Ucrainei și vom rezolva acest caz. Acest lucru se va întâmp
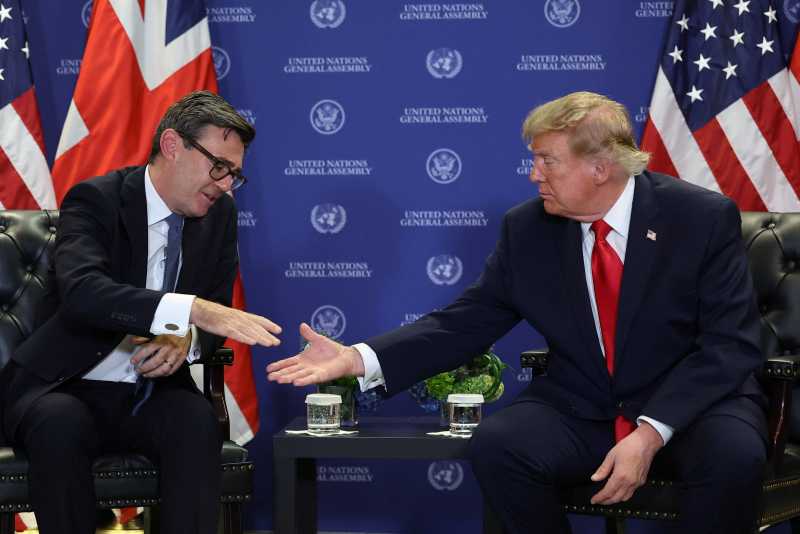
Trump salută relațiile 'mai bune' cu Marea Britanie sub conducerea lui Burnham
Președintele american Donald Trump a afirmat marți că relațiile cu Regatul Unit sunt mai bune sub noul prim-ministru Andy Burnham, criticând în același timp acordul care prevede retrocedarea Insulelor Chagos către Mauritius, informează AFP. Cei doi lideri s-au întâlnit pentru prima dată în marja Adunării Generale